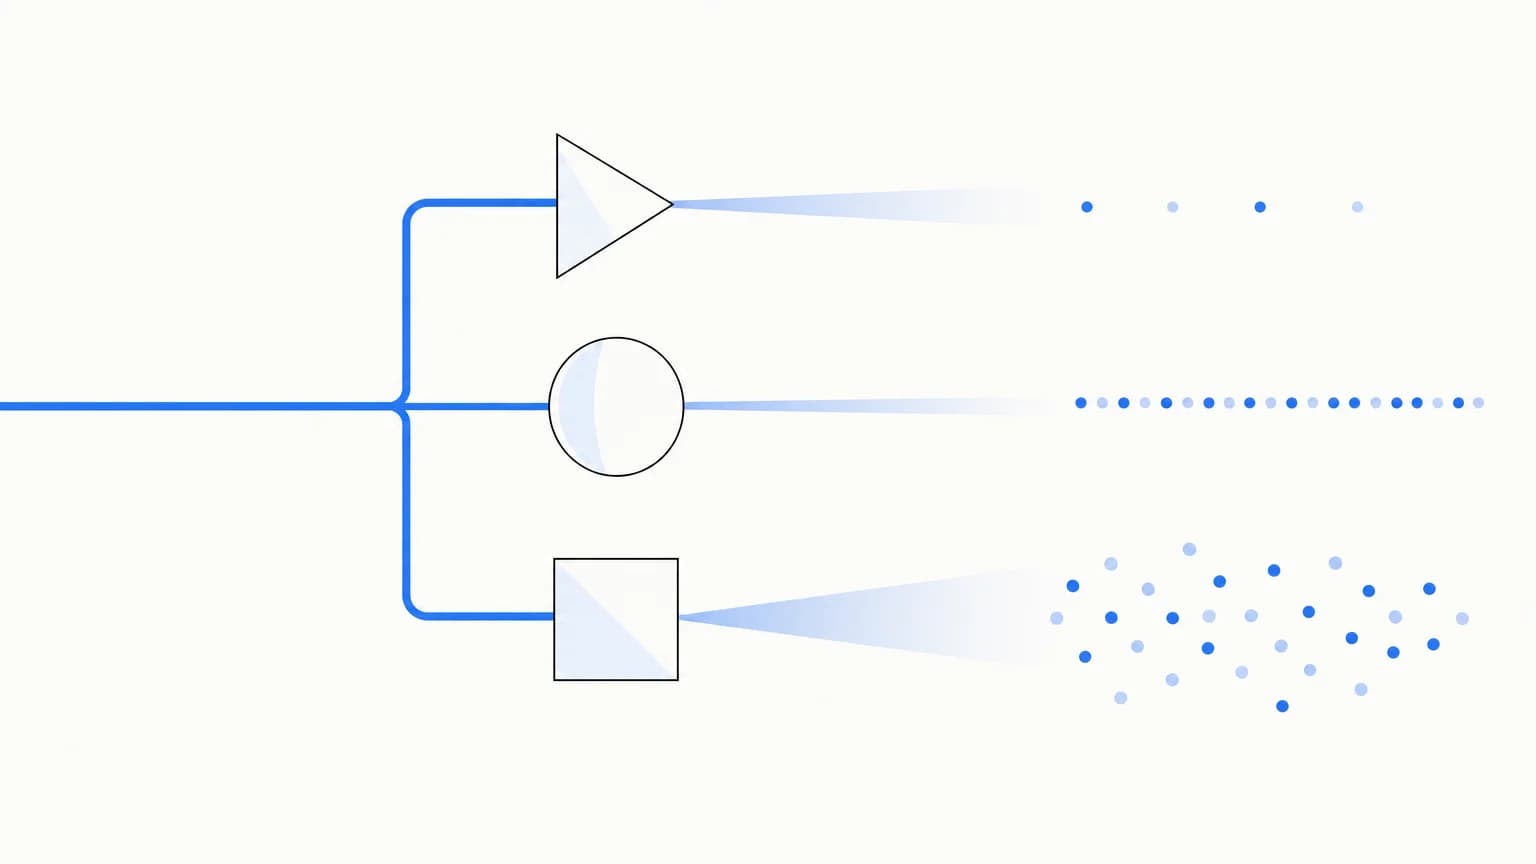
Z perspektywy marki „silniki AI” brzmią jak jedna kategoria: pytasz, dostajesz odpowiedź, w odpowiedzi ktoś jest wymieniony albo nie. W środku to jednak trzy różne maszyny, które inaczej sięgają po treść, inaczej ją cytują i inaczej rozkładają uwagę między strony marek a strony trzecie. Poniżej: mechanika każdego silnika według oficjalnej dokumentacji (stan na 27 lipca 2026 r.) oraz nasze własne dane o tym, ile źródeł faktycznie podaje każdy z nich — z 360 odpowiedzi zebranych w polskich kategoriach.
ChatGPT: model, który sam decyduje, czy szukać
W Responses API OpenAI wyszukiwanie jest narzędziem, które model może wywołać — nie obowiązkowym krokiem. Dokumentacja opisuje to wprost: po włączeniu narzędzia model „can choose to search the web based on the prompt”, a w odpowiedzi pojawia się element wywołania wyszukiwania (z akcjami typu wyszukaj, otwórz stronę, znajdź w stronie) oraz właściwa wiadomość z adnotacjami. Cytowania mają postać adnotacji url_citation: adres, tytuł i zakres znaków w tekście, których dotyczą. OpenAI nakłada przy tym obowiązek wyświetlania: „inline citations must be made clearly visible and clickable in your user interface”.
Konsekwencja dla marki jest podwójna. Po pierwsze, część odpowiedzi powstaje bez sięgania do sieci — wtedy liczy się to, co model „pamięta” o Twojej kategorii, a nie to, co dziś jest na Twojej stronie. Po drugie, gdy model już szuka, sięga po źródła oszczędnie — i tym samym o miejsce w odpowiedzi konkuruje mniej stron.
Perplexity: wyszukiwarka, która pisze odpowiedź
Tu kolejność jest odwrotna. Perplexity to produkt zbudowany wokół wyszukiwania, a odpowiedź modelu jest jego streszczeniem. Do 31 sierpnia 2026 API mówiło to wprost: w odpowiedzi były osobne pola citations — „URLs of sources used to generate the response” — oraz search_results, czyli lista wyników z tytułem, adresem, datą publikacji, datą aktualizacji i fragmentem tekstu, opisana jako „search results used for context in the response”.
To już nieaktualne i trzeba to powiedzieć bez owijania. Perplexity wygasza stare API (/chat/completions przestaje działać 27 września 2026) i przenosi ruch na /v1/agent; nasz pomiar przenieśliśmy tam 31 sierpnia 2026 i tego samego dnia sprawdziliśmy na żywo, co nowe API zwraca. Dla modelu perplexity/sonar odpowiedź nie zawiera ani znaczników [n] w treści, ani pola annotations — jedyną listą źródeł są wyniki wyszukiwania, które silnik pobrał. Praktyczny wniosek dla marki i dla każdego, kto mierzy Perplexity: z odpowiedzi nie da się dziś odczytać, na które źródła się powołała. Widać wyłącznie, co znalazła — i to dwie różne rzeczy, choć w narzędziach obie bywają nazywane „cytowaniami”.
Dla marki oznacza to najbardziej „wyszukiwarkowy” model gry: jeśli Twoja strona nie znajdzie się w wynikach wyszukiwania na dane pytanie, praktycznie nie ma szans wejść do odpowiedzi. Widoczna jest za to data — Perplexity zwraca w wynikach informację o publikacji i aktualizacji, więc świeżość treści ma tu bezpośrednie przełożenie.
Gemini: ugruntowanie w wyszukiwarce Google
Gemini korzysta z mechanizmu grounding with Google Search. Przebieg jest opisany w dokumentacji jako pięć kroków: pytanie, analiza pytania, wykonanie wyszukiwania, przetworzenie wyników i zwrot odpowiedzi z cytowaniami. W odpowiedzi API pojawia się element google_search_call zawierający zapytania, które model faktycznie wykonał, element google_search_result ze snippetem HTML do wyświetlenia podpowiedzi wyszukiwania oraz tekst z adnotacjami url_citation, wiążącymi fragment odpowiedzi (przez indeks początku i końca) z konkretnym adresem.
Najciekawszy jest tu pierwszy element: lista zapytań, które model wygenerował z Twojego pytania. To ta sama idea, którą Google opisuje jako query fan-out — jedno pytanie użytkownika staje się wiązką zapytań pobocznych, dzięki czemu, jak pisze Google, funkcje AI mogą pokazać „a wider and more diverse set of helpful links”. Marka konkuruje więc nie o jedno zapytanie, tylko o kilkanaście, których nigdy nie zobaczy.
Ile źródeł podaje każdy silnik — nasze dane
Teoria się kończy, zaczynają liczby. W edycji rankingów (lipiec 2026) zadaliśmy 60 pytań zakupowych trzem silnikom po 2 razy, co dało 360 odpowiedzi. Żadne pytanie nie wymieniało marki. Z tych odpowiedzi policzyliśmy wszystkie adresy podane jako źródła:
Zanim porównasz te liczby z nowszymi. Cytowania Perplexity zmieniły znaczenie 31 sierpnia 2026: tego dnia przenieśliśmy pomiar na nowe API Perplexity (/v1/agent — stare /chat/completions wygasło 27 września 2026), a nowe API dla modelu perplexity/sonar nie zwraca już ani znaczników [n] w treści odpowiedzi, ani pola annotations (zmierzone na żywo na produkcyjnym API, nie odczytane z dokumentacji). Nie da się z niego odczytać, na które źródła powołała się odpowiedź — zostaje lista wyników wyszukiwania, które silnik pobrał (ok. 15 na odpowiedź; wcześniej cytowań bywało od 4 do 20). Od tej daty „źródła Perplexity” znaczą „to znalazł przebieg”, a nie „na to powołała się odpowiedź”. Wywołania tej edycji wykonaliśmy przed tą datą, starym API, więc jej cytowania Perplexity nadal znaczą „cytowane” i pozostają ważne — powyższe ich nie unieważnia. Nie są za to porównywalne z edycjami po 31 sierpnia 2026 — zestawianie ich na osi cytowań Perplexity byłoby porównywaniem dwóch różnych rzeczy. ChatGPT (url_citation), Gemini (grounding) i Claude (web_search_result_location) zwracają cytowania bez zmian — ich liczby znaczą to samo, co wcześniej.
- Gemini — 1647 adresów w 120 odpowiedziach, średnio 13,73 na odpowiedź; źródła w 114 z 120 odpowiedzi (licząc wyłącznie odpowiedzi ze źródłami: 14,45 adresu).
- Perplexity — 1497 adresów w 120 odpowiedziach, średnio 12,48 na odpowiedź; źródła w 120 z 120 odpowiedzi.
- ChatGPT — 431 adresów w 120 odpowiedziach, średnio 3,59 na odpowiedź; źródła w 119 z 120 odpowiedzi (licząc wyłącznie odpowiedzi ze źródłami: 3,62 adresu).
Różnica między najhojniej a najskąpiej cytującym silnikiem jest 3,8-krotna i wynika wprost z architektury opisanej wyżej: narzędzie wywoływane na żądanie wobec wyszukiwania jako fundamentu odpowiedzi. Dla marki oznacza to, że w silniku ChatGPT konkurujesz o kilka miejsc, a w silniku Gemini o kilkanaście — szansa „wejścia do odpowiedzi” bocznymi drzwiami jest w tym drugim po prostu większa.
Kogo cytują — i dlaczego to zmienia plan działania
Jeszcze ciekawsze od liczby źródeł jest ich pochodzenie. Sprawdziliśmy, ile z dziesięciu najczęściej cytowanych domen każdego silnika to strony samych mierzonych marek, a ile serwisy zewnętrzne:
- ChatGPT — 8 z 10 domen to strony marek (m.in. orange.pl, pkobp.pl, mbank.pl); poza nimi w czołówce m.in. gov.pl, rankomat.pl.
- Perplexity — 2 z 10 domen to strony marek (m.in. uniqa.pl, orange.pl); poza nimi w czołówce m.in. bankier.pl, rankomat.pl, direct.money.pl.
- Gemini — 2 z 10 domen to strony marek (m.in. orange.pl, play.pl); poza nimi w czołówce m.in. rankomat.pl, youtube.com, jakdorobic.pl.
To najbardziej praktyczna obserwacja z całego pomiaru. W silniku ChatGPT własna strona marki jest realnym źródłem odpowiedzi; w pozostałych o marce opowiadają głównie cudze rankingi i porównywarki. Praca nad widocznością wygląda więc inaczej: tam porządkowanie własnych treści, tu obecność i aktualność wpisów w zestawieniach branżowych. Pełną listę cytowanych domen opisaliśmy w analizie kogo cytują silniki AI w Polsce.
Nie ma jednej „widoczności w AI”
Ostatnia rzecz, której nie widać, dopóki nie zmierzy się kilku silników naraz: te same marki wypadają w nich diametralnie różnie. Trzy największe rozjazdy z naszej edycji:
- Apteka Gemini — 8,3% odpowiedzi w silniku Perplexity i 87,5% w silniku Gemini.
- Bank Pekao — 4,2% odpowiedzi w silniku ChatGPT i 79,2% w silniku Gemini.
- PZU — 16,7% odpowiedzi w silniku Perplexity i 91,7% w silniku Gemini.
Uśrednianie takich wartości do jednego wskaźnika „widoczność w AI” niszczy informację, która jest najcenniejsza — w którym silniku marki nie ma i dlaczego. Dlatego każdy nasz raport rozbija wyniki per silnik, a definicje metryk i mianowniki opisujemy na stronie jak mierzymy.
Co z Google AI Overviews
AI Overviews to czwarta powierzchnia, którą mierzymy w produkcie. Warto pamiętać, że to nie to samo co Gemini: Google zaznacza, że AI Mode i AI Overviews „may use different models and techniques, so the set of responses and links they show will vary”. Stanowisko wyszukiwarki co do optymalizacji jest przy tym jednoznaczne: „There are no additional requirements to appear in AI Overviews or AI Mode, nor other special optimizations necessary”, a do pojawienia się w tych funkcjach nie trzeba tworzyć „new machine readable files, AI text files, or markup”.
Co z Claude
Od 31 sierpnia 2026 r. mierzymy też piąty silnik — Claude od Anthropic (od planu Pro, raz w tygodniu, w poniedziałki). Mechanika jest bliska ChatGPT: według dokumentacji Anthropic model sam decyduje, czy szukać, a cytowania przy wyszukiwaniu są zawsze włączone i wskazują adres, tytuł i do 150 znaków cytowanego fragmentu. Liczby w tym wpisie pochodzą z edycji rankingów bez pomiaru Claude, więc go nie obejmują. Jak Claude szuka, jakie boty wysyła i co ustawić w robots.txt, opisujemy w poradniku jak pojawić się w Claude.
Cztery wnioski na koniec
- Mierz każdy silnik osobno. Jedna liczba zbiorcza ukrywa rozjazdy sięgające kilkudziesięciu punktów procentowych.
- Tam, gdzie silnik cytuje strony marek, dbaj o własną stronę. To ona jest wtedy materiałem, z którego powstaje odpowiedź.
- Tam, gdzie cytuje zestawienia — pracuj nad obecnością w cudzych rankingach. Porównywarki i media branżowe są tam głównym budulcem odpowiedzi.
- Pamiętaj o odpowiedziach bez źródeł. Jeśli silnik nie sięgnął do sieci, mówi z pamięci — a na to wpływa się miesiącami, budując rozpoznawalność marki, nie jednym wpisem na blogu.
Najczęstsze pytania
Który silnik podaje najwięcej źródeł?
W naszej edycji rankingów (lipiec 2026, 360 odpowiedzi) najwięcej adresów na odpowiedź podał Gemini — średnio 13,73, a najmniej ChatGPT — 3,59. Różnica nie oznacza, że jeden silnik jest rzetelniejszy: wynika z architektury, bo w jednych produktach wyszukiwanie jest narzędziem wywoływanym na żądanie, a w innych fundamentem odpowiedzi.
Czy każda odpowiedź AI zawiera cytowania?
Nie. W tym pomiarze źródła padły w 353 z 360 odpowiedzi — część odpowiedzi powstała bez sięgnięcia do sieci. Dla marki to istotne: taka odpowiedź opiera się na tym, co model „pamięta” z treningu, i wtedy zmiany na stronie nie zadziałają w krótkim terminie.
Czy liczby cytowań Perplexity da się porównywać z nowszymi pomiarami?
Cytowania Perplexity zmieniły znaczenie 31 sierpnia 2026: tego dnia przenieśliśmy pomiar na nowe API Perplexity (/v1/agent — stare /chat/completions wygasło 27 września 2026), a nowe API dla modelu perplexity/sonar nie zwraca już ani znaczników [n] w treści odpowiedzi, ani pola annotations (zmierzone na żywo na produkcyjnym API, nie odczytane z dokumentacji). Nie da się z niego odczytać, na które źródła powołała się odpowiedź — zostaje lista wyników wyszukiwania, które silnik pobrał (ok. 15 na odpowiedź; wcześniej cytowań bywało od 4 do 20). Od tej daty „źródła Perplexity” znaczą „to znalazł przebieg”, a nie „na to powołała się odpowiedź”. Wywołania tej edycji wykonaliśmy przed tą datą, starym API, więc jej cytowania Perplexity nadal znaczą „cytowane” i pozostają ważne — powyższe ich nie unieważnia. Nie są za to porównywalne z edycjami po 31 sierpnia 2026 — zestawianie ich na osi cytowań Perplexity byłoby porównywaniem dwóch różnych rzeczy. ChatGPT (url_citation), Gemini (grounding) i Claude (web_search_result_location) zwracają cytowania bez zmian — ich liczby znaczą to samo, co wcześniej.
Czy w każdym silniku trzeba robić coś innego?
Kierunek pracy jest wspólny — być obecnym tam, skąd silniki biorą treść — ale rozkład akcentów się różni. W naszych danych ChatGPT miał w pierwszej dziesiątce cytowanych domen aż 8 stron samych mierzonych marek, podczas gdy pozostałe silniki opierały odpowiedzi głównie na porównywarkach, rankingach i mediach. Własna strona liczy się więc najbardziej tam, gdzie silnik po nią sięga; w pozostałych silnikach pracuje się przez obecność w cudzych zestawieniach.
Co z Google AI Overviews?
AI Overviews to osobna powierzchnia w wynikach Google, nie to samo co Gemini w aplikacji. Google podaje, że AI Mode i AI Overviews mogą używać różnych modeli i technik, więc zestaw odpowiedzi i linków będzie się różnił, oraz że nie ma żadnych dodatkowych wymagań ani specjalnych optymalizacji potrzebnych, by się w nich pojawić.
Źródła
- OpenAI — Web search tool w Responses API (adnotacje url_citation)
- Perplexity — API reference: pola citations i search_results (stare API /chat/completions, wygasa 27.09.2026)
- Google — Grounding with Google Search (google_search_call, search_suggestions, url_citation)
- Google Search Central — AI features and your website (brak dodatkowych wymagań, query fan-out)
- Anthropic — Web search tool (kiedy Claude szuka, cytowania web_search_result_location; odczyt 23.09.2026)
- SuperRank — Rankingi widoczności w AI, edycja lipiec 2026 (360 odpowiedzi, cytowane domeny)