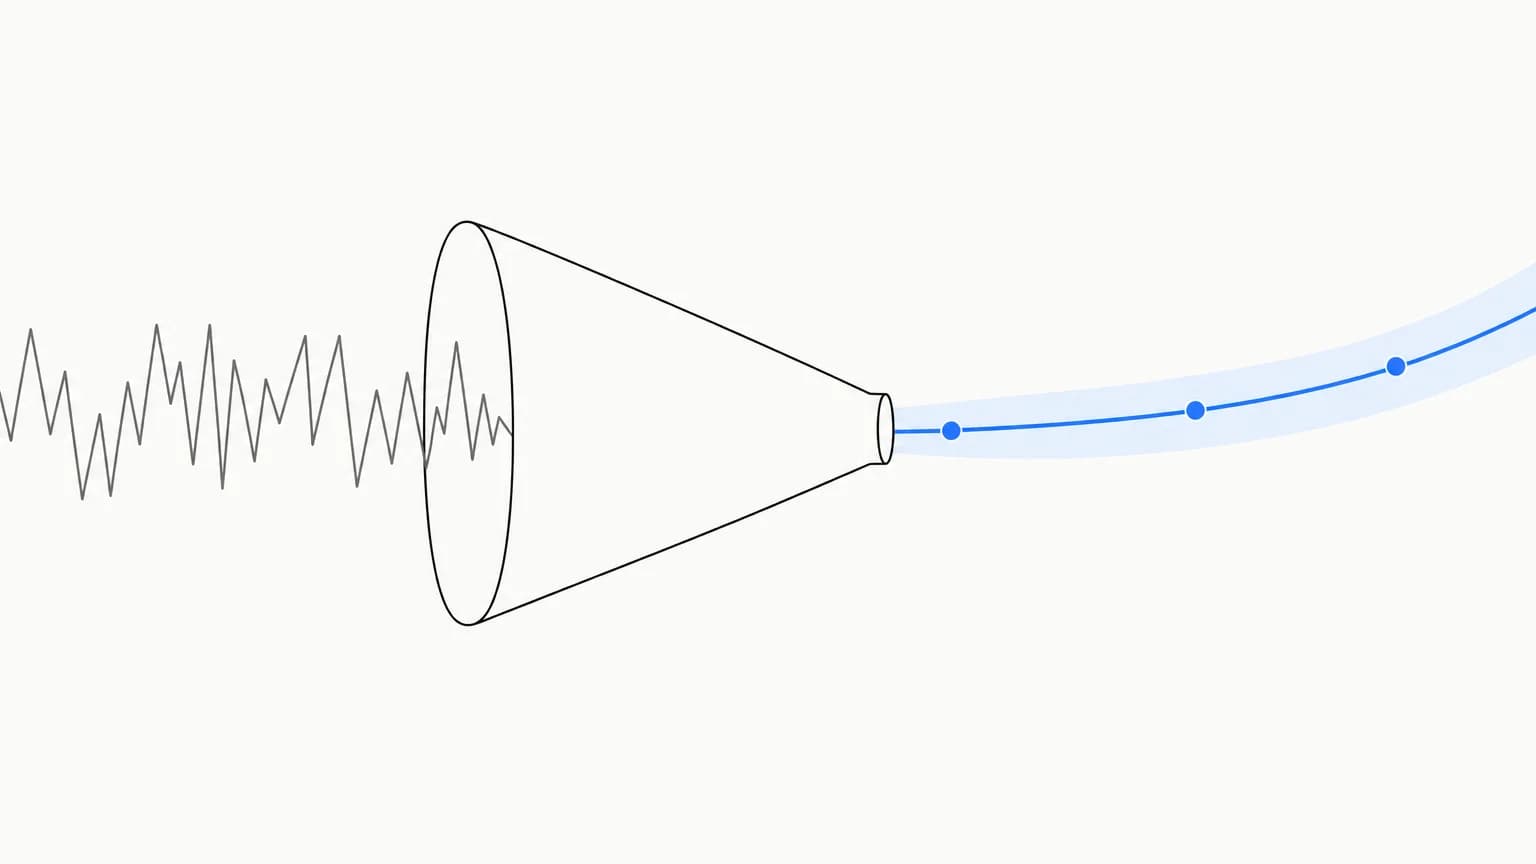
Pierwszy raport widoczności w AI zwykle wygląda tak: w poniedziałek marka pojawia się w ośmiu odpowiedziach, w środę w czterech, w piątek znów w siedmiu. Pierwszy odruch — „narzędzie się psuje”. Drugi — „coś się stało w Google”. Oba są zwykle błędne. Zmienność nie jest usterką pomiaru, tylko właściwością mierzonego zjawiska — a cała sztuka polega na tym, żeby odróżnić ją od realnej zmiany. Poniżej metodyka: skąd bierze się wahanie, czym jest próbkowanie, ile przebiegów naprawdę potrzeba i jakie liczby zobaczyliśmy we własnych pomiarach.
Dlaczego ta sama odpowiedź nie jest ta sama
Na wahanie składają się co najmniej cztery niezależne warstwy.
- Losowość modelu. Modele generują tekst przez próbkowanie kolejnych tokenów. OpenAI w dokumentacji parametru „seed” pisze, że „determinism is not guaranteed”, a nawet gdy zgadzają się parametry żądania i identyfikator konfiguracji backendu, odpowiedzi mogą się różnić „due to the inherent non-determinism of our models”.
- Zmienność wyszukiwania w tle. Silniki z dostępem do sieci najpierw szukają, potem piszą. Indeks żyje, a wyniki wyszukiwania zmieniają się w ciągu dnia. Google opisuje przy tym technikę query fan-out: jedno pytanie rozbijane jest na wiele zapytań pobocznych, których zestaw również nie jest stały.
- Różnice między silnikami. Google zaznacza wprost, że AI Mode i AI Overviews „may use different models and techniques, so the set of responses and links they show will vary”. Uśrednianie silników do jednej liczby ukrywa właśnie tę informację.
- Personalizacja po stronie użytkownika. Twoja aplikacja ChatGPT zna historię rozmów, pamięć i preferencje. Pomiar wykonany przez API bez kontekstu z definicji da inny wynik niż Twój własny czat — i to ten pierwszy jest porównywalny w czasie.
Czym jest próbkowanie — i dlaczego mierzymy raz na przebieg
Próbkowanie to decyzja: ile razy zadajesz to samo pytanie, w jakich odstępach i ile z tego wyciągasz. Kuszące jest rozwiązanie „pytajmy pięć razy i uśrednijmy” — wygląda naukowo. W praktyce to jednak pięciokrotny koszt za informację z jednego dnia. Wariancja bierze się nie tylko z modelu, ale i ze zmieniającego się indeksu, więc pięć strzałów w tej samej godzinie mierzy głównie samo siebie.
Dlatego wysyłamy każdy prompt do każdego silnika dokładnie raz na przebieg, a pewność budujemy długością serii, nie liczbą prób w jednym punkcie czasu. Trzydzieści dziennych pomiarów daje trzydzieści niezależnych obserwacji rozłożonych na miesiąc; sześć pomiarów jednego dnia daje sześć obserwacji o jednym dniu. Pełny opis tej decyzji i pozostałych parametrów jest w naszej metodologii.
Ile przebiegów potrzeba, żeby cokolwiek powiedzieć
Progi, których używamy i które można przyjąć jako punkt odniesienia dla dowolnego narzędzia:
- mniej niż 10 obserwacji — wynik oznaczony jako wstępny, nadaje się do rozmowy, nie do wniosków;
- 10–29 obserwacji — etykieta „mało danych”: widać kierunek, nie widać wielkości;
- co najmniej 5 dni pomiarów w obu porównywanych oknach — dopiero wtedy mówimy o trendzie;
- co najmniej 30 obserwacji — dopiero wtedy jakakolwiek etykieta rangowa („lider kategorii”) ma sens.
Przełóżmy to na kalendarz. Piętnaście pytań mierzonych w trzech silnikach daje 45 odpowiedzi na przebieg. Przy pomiarze codziennym próg 30 obserwacji dla pojedynczej pary pytanie–silnik mija po 30 dniach, ale próg „5 dni w obu oknach” — czyli pierwsza uczciwa rozmowa o trendzie — po dziesięciu dniach. Przy pomiarze trzy razy w tygodniu ten sam moment nastąpi po mniej więcej trzech i pół tygodnia. To jest cała różnica między planami o różnej częstotliwości: nie w liczbie danych, tylko w tym, jak szybko wolno Ci coś twierdzić.
Ile wynosi szum w praktyce — nasze liczby
W edycji rankingów (lipiec 2026) zadaliśmy 60 pytań zakupowych (po 12 na każdą z 5 branż) trzem silnikom — ChatGPT, Perplexity i Gemini — po 2 razy, tego samego dnia, przez oficjalne API, bez personalizacji i bez wymieniania w pytaniu jakiejkolwiek marki. To daje idealny materiał do pomiaru samej zmienności: dwa identyczne przebiegi, wszystko inne stałe.
Wynik: spośród 683 przypadków, w których marka pojawiła się w odpowiedzi na dane pytanie u danego silnika, 444 (65,0%) powtórzyło się w obu przebiegach. Pozostałe 239 — czyli 35,0% — to wzmianki, które wystąpiły w jednym przebiegu i zniknęły w drugim. Powtarzalność bardzo różniła się między silnikami:
- ChatGPT — 84 z 171 wzmianek powtórzonych w obu przebiegach (49,1%).
- Perplexity — 119 z 173 wzmianek powtórzonych w obu przebiegach (68,8%).
- Gemini — 241 z 339 wzmianek powtórzonych w obu przebiegach (71,1%).
Przykład konkretny: Santander Bank Polska pojawił się w odpowiedziach silnika ChatGPT na 5 pytań, ale tylko na 1 z nich w obu przebiegach. Na drugim biegunie Orange w silniku Gemini: 12 pytań ze wzmianką i wszystkie 12 powtórzone. Ten sam rynek, ten sam dzień, dwie zupełnie różne charakterystyki szumu.
Praktyczny wniosek: jeżeli marka pojawia się „co drugi raz”, to nie znaczy, że pomiar jest zepsuty. Znaczy, że jest na granicy — i że pojedynczy dzień nigdy nie odpowie na pytanie, czy to wzrost, czy spadek.
Jak odróżnić trend od szumu — pięć reguł
- Porównuj okna, nie dni. Tydzień do tygodnia, a najlepiej dwa tygodnie do dwóch tygodni. Punkt do punktu to porównywanie dwóch losowań.
- Patrz osobno na każdy silnik. W naszej edycji marka Apteka Gemini miała 8,3% udziału w silniku Perplexity i 87,5% w silniku Gemini. Uśrednienie takich wartości nie opisuje żadnej rzeczywistości.
- Trzymaj zestaw pytań zamrożony. Zmiana promptu w połowie okresu przerywa serię pomiarową. Jeżeli musisz ją zmienić — zaznacz to na wykresie jako adnotację, tak samo jak zmianę wersji modelu.
- Sprawdź mianowniki. Spadek widoczności z 60% na 40% znaczy co innego przy 100 odpowiedziach niż przy pięciu. Procent bez liczby obserwacji jest nieinterpretowalny.
- Szukaj potwierdzenia w źródłach. Realna zmiana pozycji marki prawie zawsze widoczna jest równolegle w liście cytowanych domen: pojawia się nowy ranking, znika stary artykuł. Jeśli źródła stoją w miejscu, a wykres skacze — to najpewniej szum.
Czerwone flagi w cudzych raportach
- Procent bez mianownika. „Widoczność 87%” bez informacji, z ilu odpowiedzi, to liczba dekoracyjna.
- Awaria silnika policzona jako zero. Nieudane zapytanie musi wypaść z mianownika. Wliczone jako zero produkuje spadek, którego nie było.
- Średnia pozycja liczona z braków. Jeśli brak wzmianki wchodzi do średniej jako „ostatnie miejsce”, wskaźnik miesza dwa różne zjawiska i przestaje cokolwiek znaczyć.
- Jeden zrzut ekranu jako dowód. Odpowiedź z czyjegoś konta jest niepowtarzalna: inna historia rozmów, inna pamięć, inny moment.
- Etykieta „lider” przy kilkunastu obserwacjach. Ranking na małej próbie to ranking losowań.
Jeśli chcesz zobaczyć, jak wygląda pełna metodyka zapisana na tyle szczegółowo, żeby dało się ją podważyć — łącznie z wersjami modeli, parametrami geolokalizacji i definicjami metryk z mianownikami — mamy to na stronie jak mierzymy. A jeśli chcesz zobaczyć, z jakich źródeł silniki budują odpowiedzi w polskich kategoriach, zebraliśmy dane w analizie kogo cytują silniki AI w Polsce.
Najczęstsze pytania
Dlaczego to samo pytanie daje różne odpowiedzi?
Bo modele językowe próbkują odpowiedzi, a wyszukiwanie w tle zwraca za każdym razem nieco inny zestaw źródeł. OpenAI pisze wprost, że determinizm nie jest gwarantowany, a różnice mogą wystąpić nawet przy tych samych parametrach żądania. Google zaznacza, że AI Overviews i AI Mode używają różnych modeli i technik, więc zestaw odpowiedzi i linków będzie się różnił.
Ile przebiegów potrzeba, żeby wyciągać wnioski?
Poniżej 10 obserwacji traktuj wynik jako wstępny, między 10 a 29 jako dane orientacyjne, a o trendzie mów dopiero przy co najmniej 5 dniach pomiarów w obu porównywanych oknach. W praktyce oznacza to od kilku dni do dwóch tygodni pomiarów, zależnie od liczby pytań i częstotliwości.
Jak odróżnić realny spadek od szumu?
Porównuj okna, nie dni; patrz osobno na każdy silnik, bo wyniki potrafią się rozjeżdżać wielokrotnie; sprawdź, czy nie zmieniły się prompty ani wersje modeli; upewnij się, że awarie silnika nie zostały policzone jako zera. W naszym pomiarze (lipiec 2026) dwa identyczne przebiegi dały tę samą wzmiankę marki tylko w 65,0% przypadków (444 z 683) — realny spadek utrzymuje się przez kilka kolejnych przebiegów i zwykle widać go równolegle w liście cytowanych źródeł.
Czy większa liczba prób na to samo pytanie rozwiąże problem?
Tylko pozornie i bardzo drogo. Pięć zapytań tego samego dnia to pięciokrotnie wyższy koszt i wciąż jeden dzień. Dlatego wysyłamy jedno zapytanie na silnik na przebieg, a pewność budujemy długością serii — dzienne pomiary wygładzają losowość taniej niż wielokrotne próbkowanie.
Źródła
- OpenAI Cookbook — Reproducible outputs with the seed parameter („inherent non-determinism of our models”)
- Google Search Central — AI features and your website (query fan-out, zmienność odpowiedzi i linków)
- SuperRank — Rankingi widoczności w AI, edycja lipiec 2026 (dane o powtarzalności wzmianek)
- SuperRank — metodologia: próbkowanie, mianowniki, progi „mało danych”